长篇小说逐章翻译,怎样避免前后不一致?
章节可以分批交付,但人物、术语和故事规则不能被分开判断。
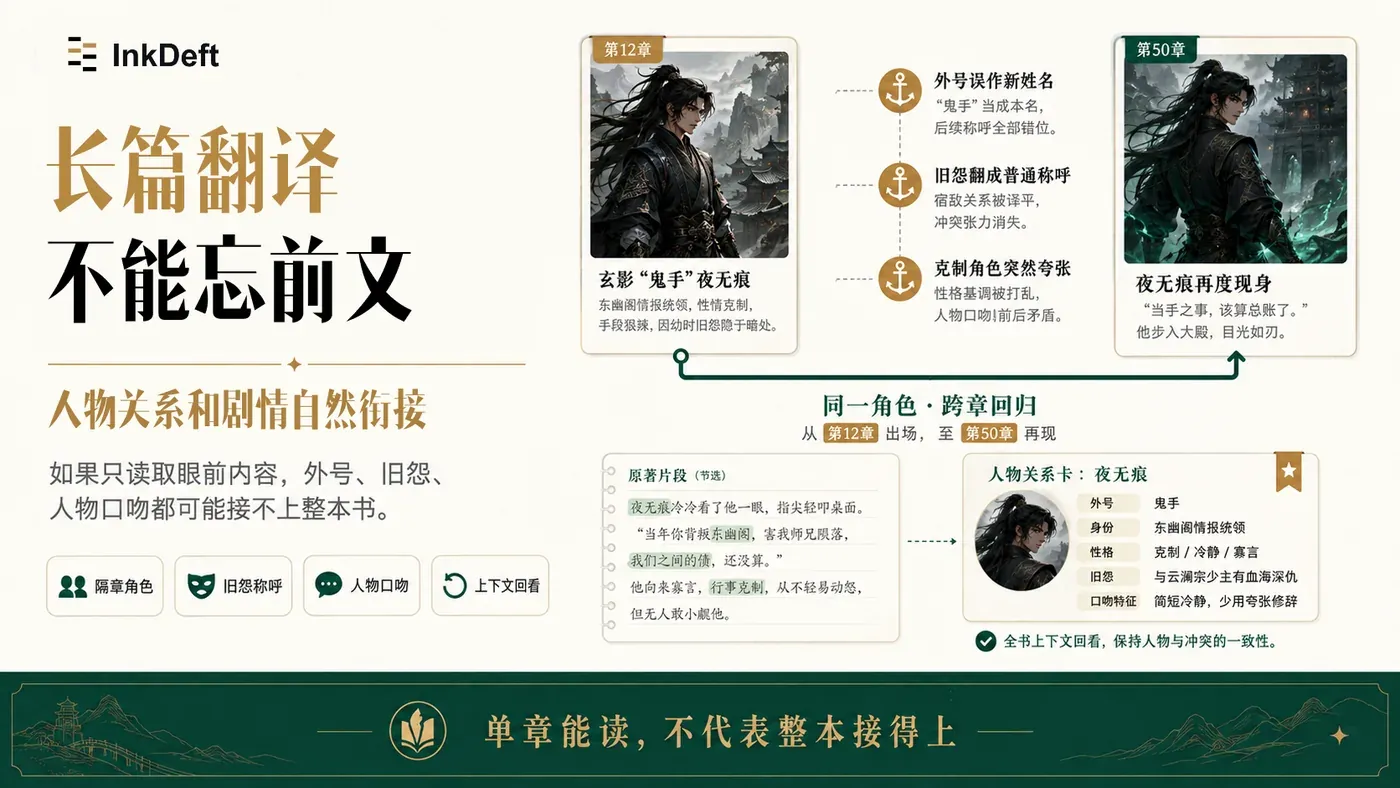
长篇小说几乎不可能一次处理完。章节分批提交、阶段验收、多人协作都很常见。问题不在逐章,而在翻译依据是否也被切成了一章一章。
逐章是交付方式,整本上下文才是翻译依据。每一批都要继承并更新同一套人物、术语和故事规则。
一、逐章翻译方便推进,也最容易切断上下文
假设一个角色在第十二章短暂出场,五十章后再次出现。当前章节可能只写了他的外号和一句挑衅,没有重复解释本名、所属阵营和过去的冲突。
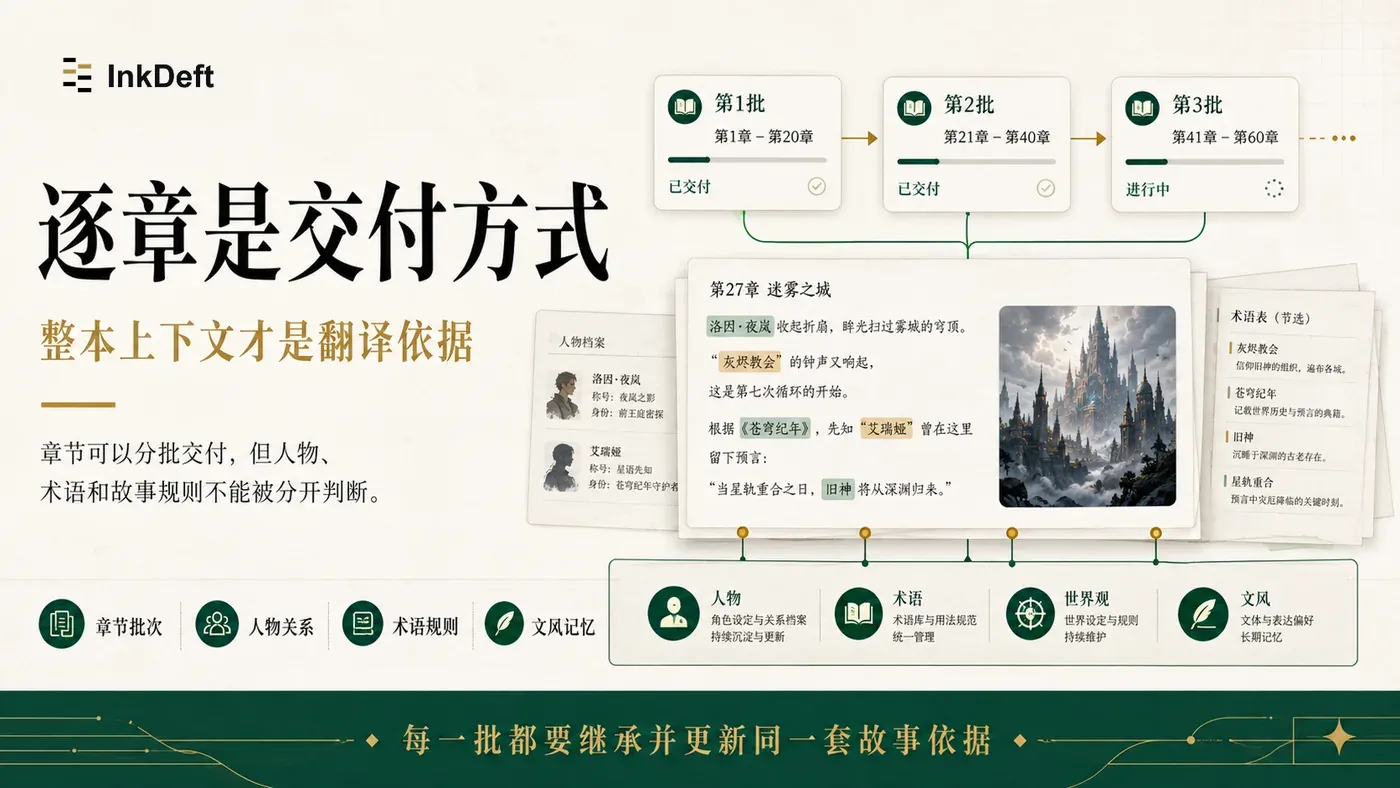
如果翻译只读取眼前内容,就可能把外号当成新姓名,把带有旧怨的称呼翻成普通称呼,甚至让这个一贯克制的人突然说得十分夸张。单看这一章,句子都能读;放回整本书,人物却已经接不上了。
分章推进的真正风险,是每批都重新猜一次。猜得越多,前后冲突越容易积累。
二、先建立整部作品共同使用的人物和设定基础
正式推进前,需要从作品中梳理后续会反复调用的信息,包括主要人物与关系、组织和地点、能力体系、固定物品以及高频表达。
客户已有译名和设定规范时,应以确认资料为基础;没有现成资料,也不能等翻到问题出现才处理,而要从原稿中逐步建立共同依据。
这份依据不是一张静止词表。它既要记录某个名称怎样翻,也要说明它是谁、与谁有关、在世界观里处于什么位置。只有知道一个词在故事里的关系,后续章节才能正确使用它。
三、术语统一之外,还要持续跟踪称谓和人物口吻
同一角色前后都使用同一个名字,只能说明姓名没有漂移。长篇的一致性还包括称谓和人物声音。
例如,早期两人是上下级,后期成为盟友。称呼发生变化是合理的;但变化应该出现在关系转折之后。如果批次切换时无缘无故改口,读者会误判剧情。相反,关系已经改变却仍使用旧称呼,也会让人物显得迟钝。
人物口吻同样如此。一个说话简短、习惯压住情绪的角色,即使愤怒,也不一定突然发表长篇控诉。翻译要继承的是人物性格,不是某几个固定句式。
角色隔很久再出现时,还要注意读者记忆。译文如果突然换成一个没有提示的新称呼,即使从词义上说得通,也会让人误以为新人物登场。更稳妥的处理,是沿用既有表达,或在剧情确实需要新增身份时,让新称呼与旧身份建立清楚联系。
四、每完成一批,都要检查它和前文能不能接上
逐章翻译的检查重点,不应只停留在本批语法和错词。每次交付前还要回看:
旧人物再次出现时,姓名、身份和称谓有没有接回前文;
新设定是否与已有体系冲突;
伏笔、回忆和反转有没有引用到正确事实;
本批对话与叙述是否突然换了一种风格。
这一步看似增加了一次核对,实际上是在缩小返工范围。今天发现一个偏差,只需要修正本批及少量关联章节;几十章后才发现,往往要重查整条人物线。
五、InkDeft以完整上下文管理逐章翻译
InkDeft面向网文、小说和系列长文本提供翻译与本地化服务。项目可以按章节推进,但处理每一批时,会继续参考整部作品已经建立的人物、术语、世界观和文风规则。
当新角色、新组织或关系变化出现后,相关信息会被补充到后续章节的依据中。这样,逐章交付不再等于每章重新开始,而是在同一部作品的背景上持续向前。
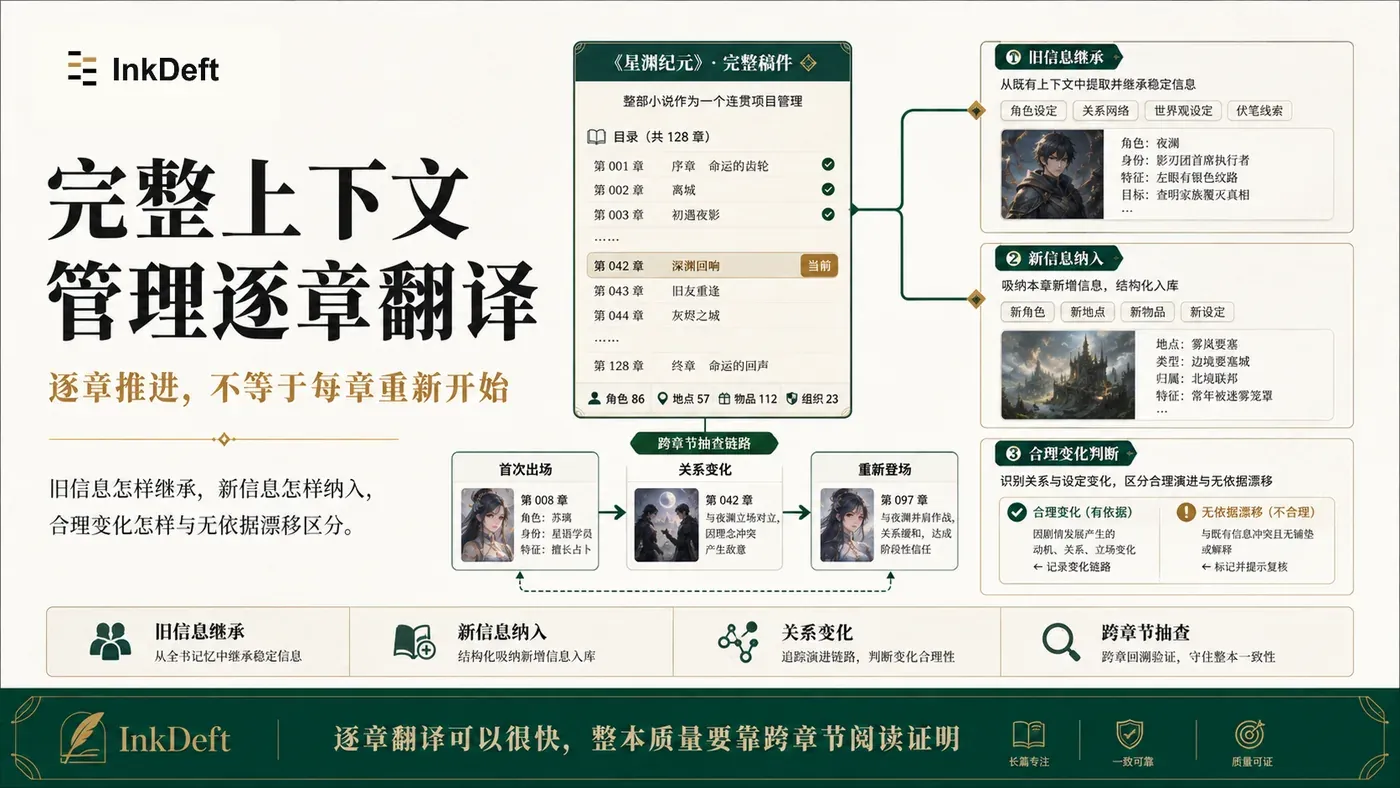
产品在这里解决的不是分章速度本身,而是三个更难的衔接问题:旧信息怎样继承、新信息怎样纳入、合理变化怎样与无依据漂移区分。
多人协作时,批次之间的交接也要落到作品信息上,而不是只交付文件。下一批接手者需要知道哪些人物已经定调、哪些称谓随关系变化、哪些设定仍有待后文确认。否则交付再整齐,判断仍会从头开始。
六、判断有没有前后一致,要跨章节抽查
验收时,可以选择一个隔几十章再次出现的角色,依次查看首次出场、关系变化和重新登场三个节点。再挑一个技能或组织,检查它的名称、能力边界和剧情作用是否连续。
如果只抽查相邻章节,很容易错过真正的长文本问题。逐章翻译可以很快,整本质量却要靠跨越章节的阅读来证明。
如果作品正在分批更新,可以向InkDeft提交完整原稿或章节目录、目标语言、更新节奏和已有译名,确认逐章翻译与持续交付方式。
了解 InkDeft
查看介绍与样片:InkDeft 产品介绍与样片
联系我们:提交项目需求